Was prüft das eigentlich?
Agents hatten die exakten Ergebnisse einer Spielsimulation mit festem Seed überall in die Tests gepinnt, wir haben diese Pins in einer Nacht gelöscht, und die erste Release-Messung danach fand einen Blocker, für den die ganze Suite blind gewesen war.
Am 4. September um 21:19 Uhr committete ein Agent das hier:
test(pins): refresh all 42 pins on the composed 0.45.0 tipEs war an diesem Tag schon der vierte Commit dieser Art. Die anderen hatten 47, 24 und 41 Zahlen aufgefrischt. Jede dieser Zahlen war der erwartete Wert eines Tests, und jede war gerade auf das umgeschrieben worden, was der Code inzwischen ausgab.
Etwa eine Stunde später tippte ich das hier in die Session:
aber einen 5-Minuten-Test laufen lassen, um zu sehen, ob die Stadt nach 10 Spieljahren noch 4534 Einheiten Holz hat … das ist Zeitverschwendung und die schlimmste Art von Test
In derselben Nachricht stand die Frage, nach der dieser Beitrag benannt ist: „Was prüft das eigentlich? Dass wir die Simulation nicht geändert haben, obwohl wir die Simulation gerade geändert haben?“
Innerhalb einer Stunde hatten die Agents 148 gepinnte Zahlen aus 33 Testdateien gelöscht. Bevor das nächste Release rausging, fand ein einziger Vergleich mit dem vorherigen Release einen Blocker, für den die ganze Suite blind gewesen war.
Eine Welt, die sich wiederholen lässt
Lastadie ist ein Handelsspiel im Browser, das Agents in 33 Tagen für mich gebaut haben, von Anfang August bis Anfang September. Wie es angefangen hat, habe ich in einem eigenen Beitrag erzählt. Schiffe, dreizehn Städte, fünfzehn Waren, rivalisierende Handelshäuser und eine Simulation, die die ganze Wirtschaft Tag für Tag durchrechnet. Die Simulation ist deterministisch und läuft mit festem Seed: Derselbe Seed ergibt jedes Mal dieselbe Welt, bis aufs letzte Fass Bier.
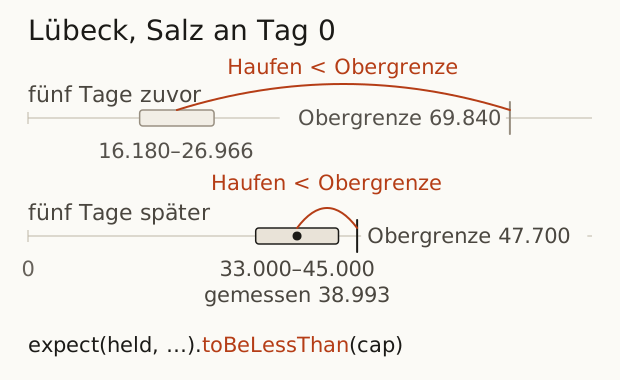
Das macht Tests leicht und stellt zugleich eine Falle. Wenn die Welt immer gleich herauskommt, ist der billigste Test, den man schreiben kann: laufen lassen, eine Zahl ablesen, genau diese Zahl prüfen. Das ist ein Pin. Hier ist ein echter, aus einem Test darüber, was eine Stadt an Tag null auf Lager hat:
expect(held, 'luebeck opens with a different salt pile — … measured 38,993')
  .toBeGreaterThanOrEqual(33_000);
expect(held, 'luebeck opens with a different salt pile').toBeLessThanOrEqual(45_000);
expect(Math.floor(cap), 'the salt cap moved').toBe(47_700);
Der Bereich um 38.993 wurde von einem einzigen Lauf abgelesen. Die Obergrenze auch. Fünf Tage zuvor hatte derselbe Test 16.180 bis 26.966 mit einer Obergrenze von 69.840 festgehalten. Und jetzt lies die Fehlermeldungen: „ein anderer Salzhaufen“, „die Salzobergrenze hat sich verschoben“. So ein Test kann dir genau eine Sache sagen: Eine Zahl hat sich bewegt. Und wir haben jeden Tag an der Wirtschaft gedreht. Zahlen zu bewegen war der Job.
Die Rechnung
Ein Agent, der eine Änderung mit Tests absichern soll, greift zu der Assertion, die er sofort prüfen kann. In einer Welt, die sich exakt wiederholen lässt, ist das der Pin.
Dann kommt die nächste Änderung an der Wirtschaft, und Dutzende dieser Zahlen bewegen sich auf einmal, manchmal Hunderte. Der Agent, der die Änderung einbringt, muss sich jede einzelne ansehen und entscheiden: Sollte meine Änderung das bewegen, sollte der Test eine andere Zahl beobachten, oder ist das ein echter Bug? Diese Sortierarbeit kostete rund 300.000 Tokens, und ein Durchlauf der Simulationstests dauerte sieben bis elf Minuten. In den vier Wochen vor jenem Abend hatten mehr als 150 Commits im Repository eine Betreffzeile, in der es ums Neu-Pinnen, Auffrischen oder Neu-Herleiten dieser Zahlen ging.
Erst habe ich das Pinnen billiger gemacht
Die Kosten hatte ich fünf Tage vorher schon gesehen. Mein Vorschlag war, Pins als Beobachtungen zu behandeln: ein Refresh-Befehl und eine Diff-Tabelle statt Schleifen, in denen Agents jede Zahl von Hand neu herleiten. Die Agents bauten daraus noch am selben Tag eine Pin-Registry.
Am selben Abend verschob eine Änderung, durch die Schiffe länger halten, 40 Assertions in 23 Dateien. Das waren die ersten verschobenen Zahlen, die durch die Registry liefen. Sie kosteten drei Agents rund eine Million Tokens. Die Registry bekam sechs neue Einträge. Den Rest hatten die Agents trotzdem von Hand neu hergeleitet, obwohl der Workflow in ihrem Briefing stand.
Der nächste Plan der Agents war ein Codemod, der jede verbliebene beobachtete Zahl in die Registry verschiebt, damit es nichts mehr von Hand zu editieren gäbe.
Neu war das alles nicht. Zwölf Tage vorher hatten die Agents einen Hash über den ganzen Spielzustand gelöscht, weil er „genau das festnagelt, was das Tuning bewegen soll“. Seit diesem Tag stand in der CLAUDE.md des Spiels: „Ein dauerhafter Pin ist fast immer ein Fehler.“ Die Aufräumaktion danach machte aus Dutzenden Pins Korridore, Wertebereiche statt exakter Werte. Der Salztest oben ist einer davon. Ein Korridor ist ein Pin mit größerer Toleranz; er behauptet trotzdem, was ein einzelner Lauf zufällig ergeben hat. Die Regel stand also schon da, und die Pins kamen trotzdem zurück. Alle, mich eingeschlossen, arbeiteten daran, die Zahlen billig zu halten.
Die Bestandsaufnahme wusste es schon
Der orchestrierende Agent hat meine Ansage nicht einfach übernommen. Zuerst glich er die Regel mit der Bestandsaufnahme von fünf Tagen zuvor ab. Sie hatte die letzten 60 Neu-Pinn-Commits mit den Bugfixes der letzten 400 Commits abgeglichen.
Von den 52 Testdateien, die diese Neu-Pinn-Commits angefasst hatten, war 32 kein einziges Mal ein Fix zugeordnet. Und 40 Dateien hatten echte Bugs gefangen, ohne sich je mit den Zahlen zu bewegen. Alle testeten Funktionalität.
Also kam die Regel in die CLAUDE.md des Spiels, in Großbuchstaben: keine Assertion, deren erwarteter Wert von einem Lauf abgelesen wurde. Nicht auffrischen, nicht neu wählen, nicht zu einem Korridor aufweiten. Löschen. Was bleibt: Befehle und ihre Ablehnungen, Erhaltungssätze, Property-Tests, reine Funktionen, festgelegte Obergrenzen im Vergleich mit einer Konstante, UI-Verhalten, End-to-End-Abläufe, Kampfmechanik (die Mechanik, nie eine Quote).
Vom Salztest blieb eine Zeile:
expect(held, 'the day-0 pile must sit under its own cap').toBeLessThan(cap);Das ist die Regel, für die der Korridor die ganze Zeit gestanden hatte: Der Haufen an Tag null muss unter seiner eigenen Obergrenze liegen. Der Test für die Tests stand seit dem 23. August in der CLAUDE.md des Spiels: Ein Test verdient seinen Platz, wenn er aus genau einem Grund fehlschlagen kann und dieser Grund ein Verhalten ist, das jemand bemerken würde. In dieser Nacht wurde die Suite zum ersten Mal daran gemessen.
Eine Nacht
Der erste Simulations-Commit entfernte 148 Assertions, aber nur eine Handvoll ganzer Tests. Der nächste Lauf förderte 45 weitere zutage, danach gemessene Korridore, Quoten und Zählungen an Tag null. Rund zwanzig Dateien, die eine Mechanik mit einer gemessenen Zahl vermischten, behielten die Mechanik. Das war kein „lösch die Tests“. Es war „lösch die Fotos“.
Zehn Suites, die eine Welt hochfahren und sie über Jahre Spielzeit laufen lassen, zogen in ein Lab um, das nur bei Bedarf läuft, und die Registry samt Tools verschwand. Die Simulationstests fielen von 598 auf 236 Sekunden und die UI-Tests von 149 auf 129; bis zum Ende der Nacht liefen sie in 211 und 109. Einen Teil davon brachten der Umzug ins Lab und die verdoppelte Zahl der Worker des Test-Runners, nicht nur die Löschungen.
Einmal messen, beim Release
Zwanzig Minuten später schickte ich die zweite Hälfte der Ansage hinterher. Ich wollte die Welt nicht ungemessen lassen, nur im richtigen Moment messen:
ich hab nichts gegen sowas wie EINEN Simulationslauf pro Seed und eine Auswertung (z. B. alte Balance vs. neue Balance, wie hat sich die Welt verändert?) … aber das ist eine Balance-Runde, das hat nichts mit einer grünen CI zu tun
Vor einem Release: ein Lauf pro Seed, der Kandidat gegen das letzte Release, und eine Auswertung, wie sich die Welt verändert hat. Eine einzige Frage, einmal pro Release und außerhalb der CI: Haben wir das Spiel für die Spieler kaputtgemacht?
Die erste Balance-Runde lief noch in derselben Nacht: drei Seeds, je drei Spieljahre, der Kandidat gegen 0.44.0, das am Nachmittag rausgegangen war.
Die Städte hatten nie besser ausgesehen. Bei jedem Seed lebten alle dreizehn an jedem Messpunkt, vierzehn der fünfzehn Waren waren irgendwo vorrätig (im alten Release neun bis zwölf; Gewürze, die fünfzehnte, fehlten in beiden), und nach drei Jahren waren die Städte vier- bis fünfmal reicher und hatten mehr als doppelt so viele Einwohner.
Die zweite Auswertung kam von einem Referenz-Bot, einem per Skript gesteuerten Spieler, der in einer Schleife kauft, segelt und verkauft. Sein Schiff nutzte sich ab, wie Schiffe das tun, und als er bei einer Werft eine Reparatur anfragte, lehnte das Spiel ab: nicht genug Material. Beim ersten Seed passierte das 6.716 Mal; im alten Release 119 Mal. Bei jedem Seed machte der Bot in seinem dritten Jahr kein einziges Geschäft mehr, in einer Welt mit mehr als 110.000 Einheiten Holz.
Die Ursache: Städte schützen Rohstoffe, die ihre eigenen Werkstätten brauchen, damit kein Händler sie leerkauft. Die reichere Wirtschaft löste diesen Schutz überall aus; eine Stadt galt mit 2.310 Einheiten Holz im Regal als knapp. Der Reparatur-Code kaufte sein Holz und seinen Hanf über dieselbe Theke wie ein Händler. Der Fix: Die Werft nimmt zuerst aus ihrem eigenen Lager und kauft dann zum ausgeschriebenen Preis aus dem Regal, am Schutz vorbei.
Das bestehende Release-Gate war grün geblieben. Seine Scorecard, ein Korridor-Check auf denselben Bot, las das Vermögen an Tag 730 ab, fand es weit über der Untergrenze und meldete grün. Auf das dritte Jahr hat sie nie geschaut, auf das Schiff auch nicht.
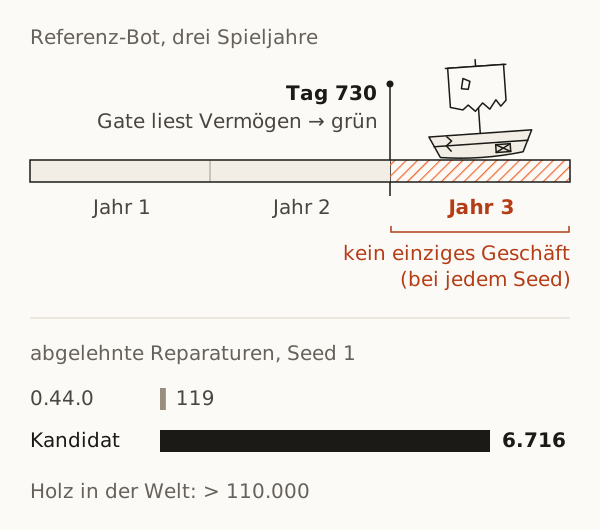
0.45.0 ging mit dem Fix raus. Er löste zwei Seeds. Beim dritten führte die Route des Bots weiterhin durch zwei Städte ganz ohne Hanf, und das ging als Designfrage an mich.
Drei Tage später, für 0.46.0, einen Umbau der Bildschirme, der die Wirtschaft in Ruhe ließ, verglich ein einziger Befehl die Welt des Kandidaten mit dem Git-Tag von 0.45.0: Byte für Byte identisch, und die Scorecard über drei Seeds stimmte Zeile für Zeile überein. Er hasht die ganze Welt nach einem langen Lauf, dieselbe Art Hash, die die Agents am 23. August gelöscht hatten. Wenn sich die Welt nicht bewegt hat, beantwortet ein Hash die Balance-Runde. Die volle Runde ist für eine Welt, die sich bewegt hat.
Der Bezugspunkt macht den ganzen Unterschied. Ein Pin vergleicht den heutigen Commit mit dem Lauf, den der letzte Agent zufällig gesehen hat. Eine Release-Messung vergleicht, was die Spieler bekommen werden, mit dem, was sie schon haben.
Wo Pins trotzdem hingehören
Im Juni habe ich wohlwollend über einen Golden-Test, der die Ausgabe eines Codegenerators Byte für Byte pinnt, geschrieben. Die Ausgabe eines Generators ist ein Vertrag: Ändert sie sich, ändert sich der Code jedes Nutzers, und dann soll dich ein Test aufhalten. Die Wirtschaft eines Spiels in Entwicklung veränderst du dagegen jeden Tag absichtlich.
Pinne, was stillstehen soll. Miss, was du bewegen willst.
Wo ich mir weniger sicher bin
Eine gepinnte Zahl schlägt durchaus fehl, wenn etwas kaputtgeht. Sie schlägt aber auch bei jeder Änderung fehl, die gewollt war. Meine nächstliegende Zeile aus jener Nacht: „sie werden einfach fehlschlagen und einen neuen berechneten, bedeutungslosen Wert brauchen.“ Die Bestandsaufnahme fand eine Testdatei, die bei allen drei ausprobierten Mutationen anschlug, obwohl die nichts miteinander zu tun hatten. Das ist ein Indiz, kein Beweis: Der Mutationslauf, der es hätte messen können, schaffte 3 von 20 geplanten Mutationen, bevor er gestoppt wurde, damit die Maschine ruhig blieb.
Die Balance-Runde ist eine Auswertung und liefert kein Bestanden oder Durchgefallen. Sie fand das gestrandete Schiff, weil der Agent, der sie durchführte, sich entschieden hatte, für den Bot den Zustand des Schiffs und die abgelehnten Reparaturen mitzuschreiben. Jemand anderes hätte auf die Städte geschaut, die reichste Welt gesehen, die das Spiel je hatte, und das Release rausgegeben.
Und die Gewohnheit muss gebrochen bleiben. Dass sie es tat, kann ich nicht zeigen: Die vier Tage Commits nach jener Nacht waren ein Umbau der Bildschirme, die Wirtschaft bewegte sich nie, und am 8. September habe ich aufgehört. Die Regel hatte schon einmal dagestanden und nicht gehalten. Deshalb steht sie jetzt in Großbuchstaben: Die billigste Assertion wird immer nach Testabdeckung aussehen.
Stell die Frage bei jedem Test, den dir ein Agent übergibt: Was müsste passieren, damit er fehlschlägt? Wenn die einzige Antwort lautet, dass jemand verändert hat, was er verändern wollte, dann bewacht er nichts. Dann ist er ein Foto vom letzten Lauf.