Fünf Minuten, eine Stunde, drei Tage
Für ein Webinar habe ich drei Builds derselben Art von RAG-Assistent gezeigt: einen nackten Prompt, einen unbeaufsichtigten Opus-Lauf und drei Tage Sessions mit mir am Steuer; was der Opus-Lauf allein entschieden hat, braucht weiterhin einen Menschen.
Opus baute seit 78 Minuten. Um 12:47 tippte ich in meine andere Session: „opus ist immer noch nicht fertig .. arbeitet jetzt an SSO … ich frag mich, ob er überhaupt irgendwann aufhört“.
Sechsundzwanzig Sekunden später war er fertig. Er lieferte die Zusammenfassung eines funktionierenden Wissensassistenten für HR-Dokumente, gebaut, ohne mir eine einzige Frage zu stellen. Ich hatte es ihm verboten.
Dieser Lauf war einer von drei Builds, die ich am 2. Oktober im ersten Showcase-Webinar des KI-Syndikats gezeigt habe. Zwanzig Leute haben zugehört. Alle drei waren dieselbe Art System: ein Assistent, der Fragen aus den eigenen Dokumenten eines Unternehmens beantwortet und zu jeder Antwort sagt, wo er sie gefunden hat. RAG, wie man in der Branche sagt. Was sich zwischen ihnen änderte, war, wie viel Mensch drinsteckte.
Drei Builds, eine Art System
Die Vorlage war eine Use-Case-Seite auf der Website des KI-Syndikats, eine interne Wissensdatenbank. Sie zählt auf, was so ein System braucht: eine Quelle für jede Antwort, Zugriffsrechte, einen festen Satz für „weiß ich nicht“, für jede Art von Dokument eine namentlich benannte verantwortliche Person.
Die beiden unbeaufsichtigten Builds liefen in einem frischen Claude-Code-Profil: kein Gedächtnis, keine CLAUDE.md, keiner meiner Skills oder Agents. Der dritte ist älter.
| Build 1 | Build 2 | Build 3 | |
|---|---|---|---|
| Wann | 1. Oktober | 2. Oktober | Juli |
| Modell | Sonnet 5.5, Effort medium | Opus 5.5, Effort xhigh | Opus (4.8, soweit ich mich erinnere) |
| Wer entschied | das Modell | das Modell | das Modell und ich |
| Zeit | etwa 3 Minuten | 79 Minuten auf der Uhr, etwa 45 davon Arbeit | drei Tage, ein paar Sessions |
| Rechenkosten zu API-Listenpreisen | 0,29 $ | etwa 11 $, Claude Codes eigene Zählung | nicht erfasst |
Der dritte Build braucht vorab eine Vorbemerkung. ragkit ist ein Showcase-Prototyp, den ich im Juli gebaut habe, und seine Aufgabe war eine andere: ein Katalogassistent (in der Oberfläche heißt er Katalogpilot), der Fragen aus dem Innendienst zu Produkten und ihren Dokumenten beantwortet, überwiegend auf Deutsch. Dieselbe Art System, nicht derselbe Auftrag. Am Nachmittag vor dem Webinar hat ein Agent ihn auf dieselben drei HR-PDFs umgestellt, die auch der Opus-Lauf bekam, und seine Antworten über die Kommandozeile auf Claude geschaltet. Das waren sieben Commits und etwa eine Viertelstunde.
Fünf Minuten
Der erste Build war ein Probelauf am Tag davor: Sonnet 5.5 mit Effort medium, ein Prompt nach dem Muster „lies die Seite und bau das“. Etwa drei Minuten.
Er lief. Er fand Stichwörter in den Dokumenten, als Suche war er brauchbar. Er sah aus wie ein fertiges System.
Dann habe ich genauer hingeschaut und in meine Session geschrieben: „die Vanilla-App, die eine andere Instanz von dir gebaut hat, hatte nicht mal eine LLM-Suche … die war nur indexbasiert“. Ein Wissensassistent, hinter dessen Suche kein Sprachmodell stand, nur ein Index.
Am nächsten Tag ließ ich Sonnet noch einmal laufen, mit genau dem Prompt, den auch Opus bekam. Wieder baute Sonnet eine Stichwortsuche, und diesmal stand das in der Zusammenfassung: keine semantische Suche, und richtige Antworten bräuchten einen API-Key, den ich nicht gesetzt hatte.
Ein nackter Prompt liefert dir etwas, das aussieht wie das System. Ob der Kern drinsteckt, merkst du nur, wenn du weißt, wo du hinschauen musst.
Eine Stunde
Für den zweiten Build habe ich zwei Einstellungen geändert, bevor ich irgendetwas getippt habe. Das Modell auf Opus 5.5. Den Effort auf xhigh, was Claude Code als „knapp unter dem Maximum“ beschreibt. Dann eine Zeile:
Lies https://www.ki-syndikat.de/usecases/allgemein/01-interne-wissensdatenbank und bau das für unsere HR-Dokumente. Frag mich nichts.
Neunundsiebzig Minuten später hatte Opus etwa 3.300 Zeilen geschrieben, die meisten davon Python mit FastAPI. Nicht alle diese Minuten waren Arbeit. Um 11:56 wollte er sich einen eigenen Screenshot in einem Ordner außerhalb des Projekts ansehen, und bis 12:30 passierte nichts, dann wurde der Zugriff verweigert. Ohne diese Pause hat der Build etwa 45 Minuten gedauert. Hybride Suche: Embeddings plus eine eigene Stichwortsuche, die mit Umlauten umgehen kann und deutsche Komposita zerlegt. Antworten von einem lokalen Modell: Er fand die Ollama-Installation auf meinem Rechner und entschied sich dafür, mit Verweis auf den Datenschutz. Jede Aussage trug eine Nummer, die das PDF auf der richtigen Seite öffnete, mit Kapitel. Die Zugriffsrechte griffen vor der Suche, ein gesperrtes Dokument erreichte also nie den Prompt. Ein Nutzungsprotokoll und eine Auswertung für HR, Verantwortliche und Prüftermine für jedes Dokument, Texterkennung für gescannte Seiten, einen hellen und einen dunklen Modus, 15 Unit-Tests, 21 Testfragen. Seine README enthielt eine Tabelle, die jede Anforderung der Use-Case-Seite ihrer Umsetzung zuordnete.
Er hat sich auch umgesehen. Nach etwa einer Minute durchsuchte er meine Shell-Konfiguration nach Anthropic- und OpenAI-Keys und maskierte die Werte, bevor er sie ausgab. Niemand hatte ihn darum gebeten.
Claude Codes eigene Zählung für die Session kam auf etwa 11 $ zu API-Listenpreisen; darin stecken zwei kurze Runden nach dem Build. Mein Agent hat im Log nachgezählt: 86 Modellschritte, etwa 180.600 Output-Tokens, fast 20 Millionen Tokens Kontext, die erneut aus dem Cache gelesen wurden.
Fast wie ein Zwilling
Als er fertig war, habe ich ihn neben ragkit geöffnet und in meine Session geschrieben: „fast wie ein Zwilling“. Dieselben Bausteine, dieselbe Art Oberfläche, obwohl er Python gewählt hatte, wo ragkit TypeScript ist.
Ich habe meinen Agent draufschauen lassen. Als Erstes prüfte er, ob der Lauf jemals meinen Code aus dem Juli gesehen hatte. Hatte er nicht. Ein einziger Web-Abruf, die Use-Case-Seite, als reiner Text. Keine Spur von ragkit im gesamten Transkript. Die Ähnlichkeit hatte drei ganz gewöhnliche Quellen: Die Seite sagte, was zu bauen war, jedes starke Modell kennt den üblichen RAG-Werkzeugkasten, und beide Systeme lasen dieselben drei PDFs.
Bei den Features kam die Stunde nah an die drei Tage heran. Der Opus-Build hatte Dinge, die ragkit fehlen: Texterkennung, Verantwortliche pro Dokument, Prüftermine, eine Nutzungsauswertung. Umgekehrt hatte ragkit, was ihm fehlte: einen Reranker, Retrieval-Metriken, eine breitere Auswahl an Modellanbietern, zur Laufzeit umschaltbar. Eine Feature-Liste zeigt nicht, wohin die drei Tage gegangen sind.
Was die Stunde allein entschieden hat
Der Unterschied liegt in den Entscheidungen. „Frag mich nichts“ hieß: Jede Frage, die Opus mir gestellt hätte, hat er selbst beantwortet.
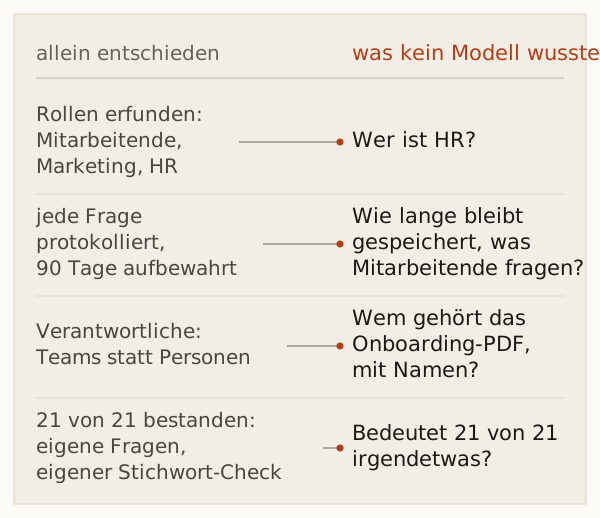
Er hat die Rollen erfunden: Mitarbeitende, ein Marketing-Team, HR. Um die Zugriffskontrolle vorzuführen, hat er die Marketing-Unterlage auf Marketing und HR beschränkt. Nichts in den Dokumenten sagte das.
Er hat für jedes Dokument Verantwortliche und Prüftermine eingetragen, mit Rolle, ohne Namen: Teams statt Personen, obwohl die Use-Case-Seite namentlich benannte Personen verlangt. Den Wikipedia-Artikel hat er am ersten Tag als überfällig markiert.
Standardmäßig hat er jede Frage im Klartext protokolliert und 90 Tage aufbewahrt. Seine eigene Zahl.
Ein eigenes Login hat er nicht gebaut, nur einen Modus, der Gruppen von einem vorgeschalteten Single-Sign-on-Proxy übernimmt, den es hier nicht gibt. In der Demo konnte sich jeder über ein Profil-Dropdown zu HR machen.
Gegen Prompt-Injection gab es eine Regel im System-Prompt: Die Auszüge sind Daten, keine Anweisungen. Kein Test dahinter.
Und 21 von 21 Testfragen bestanden. Die Fragen hat er selbst geschrieben, und die Antworten hat er mit seinem eigenen Stichwort-Check bewertet. Das kenne ich schon: Grüne Tests, die der Autor selbst geschrieben hat, sagen dir, was der Autor glaubt.
Fairerweise: Seine Zusammenfassung hatte einen Abschnitt „Was ich ohne Rückfrage entschieden habe“ und endete mit dem, was vor dem echten Einsatz zu klären ist: Verantwortliche namentlich eintragen, Single Sign-on anbinden, mit dem Datenschutzbeauftragten klären, ob Fragen 90 Tage gespeichert werden dürfen, den Betriebsrat einbeziehen. Dass sich in der Demo jeder als HR ausgeben kann, stand offen drin, auch in der README.
Das ist eine Liste von Fragen, die nur jemand beantworten kann, der dafür geradesteht. Das Modell kann hinschreiben, dass der Betriebsrat einbezogen werden sollte. Im Meeting sitzen kann es nicht.
Drei Tage
Der main-Branch von ragkit hat 89 Commits: verteilt auf den 11. Juli, den 17. Juli bis in den Morgen des 18. und einen Doku-Commit am 22. Ich war in diesen Sessions dabei. Soweit ich mich erinnere, war das Modell Opus 4.8; in den Commits steht es nicht.
Wer das Log liest, findet viele Entscheidungen, die meisten mit einer Begründung daneben:
- Manche Katalog-PDFs betten eine Schrift ein, die jeden Buchstaben verschiebt. Ein Reparatur-Durchlauf erkennt das Muster und korrigiert nur die betroffenen Seiten.
- Anfragen werden um eine bewusst kurze Liste deutscher Fachkürzel erweitert. Die mehrdeutigen bleiben absichtlich draußen, und ein Kommentar im Code sagt, warum.
- Ein Cross-Encoder-Reranker wurde gegen den leichteren Standard gemessen. Er gewann knapp bei einer Metrik, verlor bei einer anderen und war etwa achtmal langsamer. Er blieb optional.
- Um 23:34 kam eine strengere Zitierregel in den Prompt. In derselben Minute wurde sie zurückgenommen. Warum, steht nicht im Log.
- Um 01:08 wurde eine Fail-open-Lücke in der Zugriffskontrolle mit einer Default-Deny-Regel geschlossen.
- Ein Vergleich kleiner lokaler Modelle ließ den Standard mit 3 Milliarden Parametern, wo er war.
Nichts davon ist exotisch. Dahin kommst du nur, wenn du es mit echten Dokumenten laufen lässt, misst und deine Meinung änderst.
Beide Builds haben ein Demo-Login, und beide READMEs sagen das. Der Unterschied: In ragkit war es meine Entscheidung, die Lücke offen zu lassen.
Was die Stunde offen ließ
Am 2. Oktober, während der Opus-Lauf noch lief, schrieb ich in meine Session, dass jedes neue Modell-Release den Kern unseres Vortrags schwächer macht: Agents werden stärker, denken von selbst an mehr und nehmen sich der Komplexität an, statt an ihr zu scheitern. Drei Minuten später schrieb ich, dass nicht nur die technische Komplexität übernommen wird, sondern mit jedem Release auch die Geschäftslogik, die vorher vom Menschen kam: wer welche Daten sehen darf. Vielleicht komme der Agent sogar selbst auf die Idee, die Suche nach Berechtigungen zu beschränken. Der Lauf in der anderen Session hatte genau das fast eine Stunde vorher gebaut: Er filterte Dokumente nach Berechtigung, bevor er suchte. Zugriffsrechte hatte die Use-Case-Seite verlangt. Wer HR ist, hat er sich ausgedacht.
Die Stunde hat das meiste von dem ersetzt, was im Juli getippt wurde. Urteilsvermögen hat sie nicht ersetzt, und das fing schon vor dem ersten Prompt an. Während ich an den Folien arbeitete, schrieb ich: „Das Modell zu wechseln war die erste Entscheidung, die ein bisschen Können im KI-Engineering verlangte. Den weniger bekannten Effort-Parameter umzustellen war schon der zweite Eingriff, um die Qualität zu steigern.“ Und dass „all diese kleinen Entscheidungen, richtig getroffen, … am Ende zählen und sich aufsummieren.“
RAG kennt inzwischen jedes Modell. Was hier kein Modell wusste: wer HR ist, wie lange gespeichert bleibt, was Mitarbeitende fragen, wem das Onboarding-PDF gehört, mit Namen, ob 21 von 21 irgendetwas bedeutet. Früher gingen diese Fragen im Tippen unter. Jetzt sind sie der größte Teil der Arbeit.
Für fünf Minuten bekommst du die Form. Für eine Stunde einen Prototyp, der seine offenen Fragen selbst aufschreibt. Die Tage sind dafür da, sie zu beantworten.